语音与音频·EASYHUB 选读
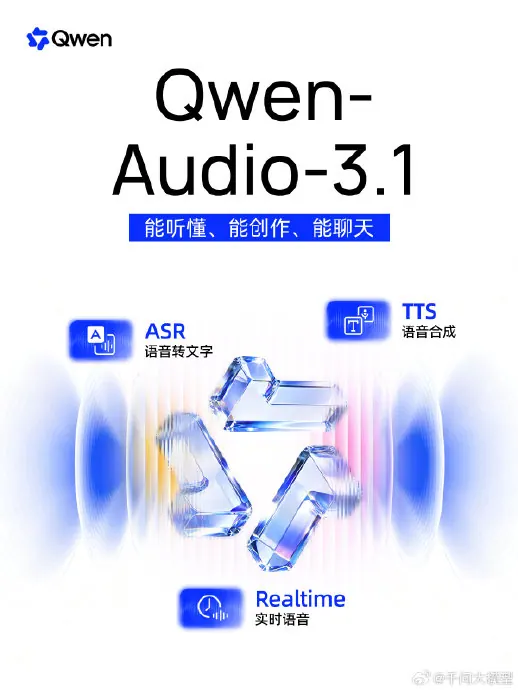
Qwen-Audio-3.1 发布五款模型,贯通转写、声景创作与实时对话
这次有什么变化
千问发布 ASR、ASR-Next、TTS、TTS-Next 和 Realtime 五款音频模型。更新覆盖转写润色、说话人与时间戳识别、可控语音合成,以及将对白、音效和环境声一并生成的声景创作;实时模型支持双向语音和工具调用。官方账号称 API 已上架千问平台,具体模型和使用额度以服务入口为准。
- 原文标题
- 🎧五模齐发!能听懂、能创作、能聊天
- 来源
- Alibaba Cloud · www.sina.cn
- 主题
- 语音与音频
- 原文月份
- 2026-09
本页是 EasyHub 根据所列来源整理的简短选读,不是完整报道或原创采访。预览、计划开放与正式可用以摘要及原文说明为准。
本站摘要页面发布 · 更新 · 内容说明